KI in der Softwareentwicklung: welche Werkzeuge wir einsetzen und wie Ihre Daten geschützt sind
TL;DR
Ein Entwickler, der mit einem KI-Assistenten arbeitet, überträgt Quellcode an dessen Anbieter. Das ist der Normalfall und vertraglich regelbar. Entscheidend sind drei Punkte: welche Werkzeuge im Einsatz sind, ob das Training auf Ihren Eingaben vertraglich ausgeschlossen ist, und was ausdrücklich nicht eingespeist wird. Wichtig dabei: Der Auftragsverarbeitungsvertrag deckt Ihren Quellcode nicht ab, er regelt personenbezogene Daten. Für den Code braucht es die Vertraulichkeitsregelungen im Projektvertrag.
Die kurze Antwort
Ja, bei der Entwicklung Ihrer Software kommen KI-Werkzeuge zum Einsatz, und ja, dabei verlässt Quellcode das Haus in Richtung der jeweiligen Anbieter.
Das ist 2026 der Normalfall in jedem Entwicklungsteam, das konkurrenzfähig arbeitet. Der Unterschied zwischen einem Dienstleister, bei dem das unproblematisch ist, und einem, bei dem es das nicht ist, liegt nicht darin, ob KI eingesetzt wird, sondern in drei Punkten: welche Werkzeuge es sind, was vertraglich zum Training vereinbart ist, und was ausdrücklich nicht eingespeist wird.
Dieser Artikel beantwortet beides: wie wir es halten, und woran Sie es bei jedem anderen Anbieter prüfen können.
Was ein KI-Werkzeug tatsächlich zu sehen bekommt
"Der Entwickler benutzt KI" klingt nach einem Chatfenster, in das jemand gelegentlich etwas hineinkopiert. In der Praxis sind es drei getrennte Wege, und der zweite ist der, an den kaum jemand denkt.

Der Prompt. Was der Entwickler bewusst eingibt: eine Frage, ein Codeausschnitt, eine Fehlermeldung. Der sichtbarste Weg und der am leichtesten zu kontrollierende.
Der Kontext aus der Entwicklungsumgebung. Ein Assistent, der im Editor mitläuft, sieht mehr als den markierten Abschnitt. Je nach Werkzeug und Einstellung gehen die geöffnete Datei, benachbarte Dateien, die Projektstruktur oder ganze Verzeichnisse als Kontext mit. Der Entwickler tippt eine Zeile und überträgt dabei mehr, als er bewusst ausgewählt hat. Bei Werkzeugen, die als Agent ganze Aufgaben übernehmen, ist dieser Kontext noch einmal deutlich größer.
Hier entscheidet sich, wie viel von Ihrem Projekt ein Anbieter zu sehen bekommt. Und hier liegt das eigentliche Risiko, nicht im Chatfenster.
Die Telemetrie. Nutzungsdaten des Werkzeugs selbst: welche Vorschläge angenommen wurden, wie oft, in welcher Umgebung. Für Ihr Betriebsgeheimnis meist unkritisch, für eine vollständige Aufstellung aber relevant.
Was bei uns hineingeht und was nicht
Unsere Entwickler folgen einer klaren internen Richtlinie: keine echten Personendaten in KI-Werkzeuge. Der Datenschutz beruht auf Privacy by Design nach Artikel 25 DSGVO, also auf einer Trennung, die bereits vor dem ersten Prompt greift.
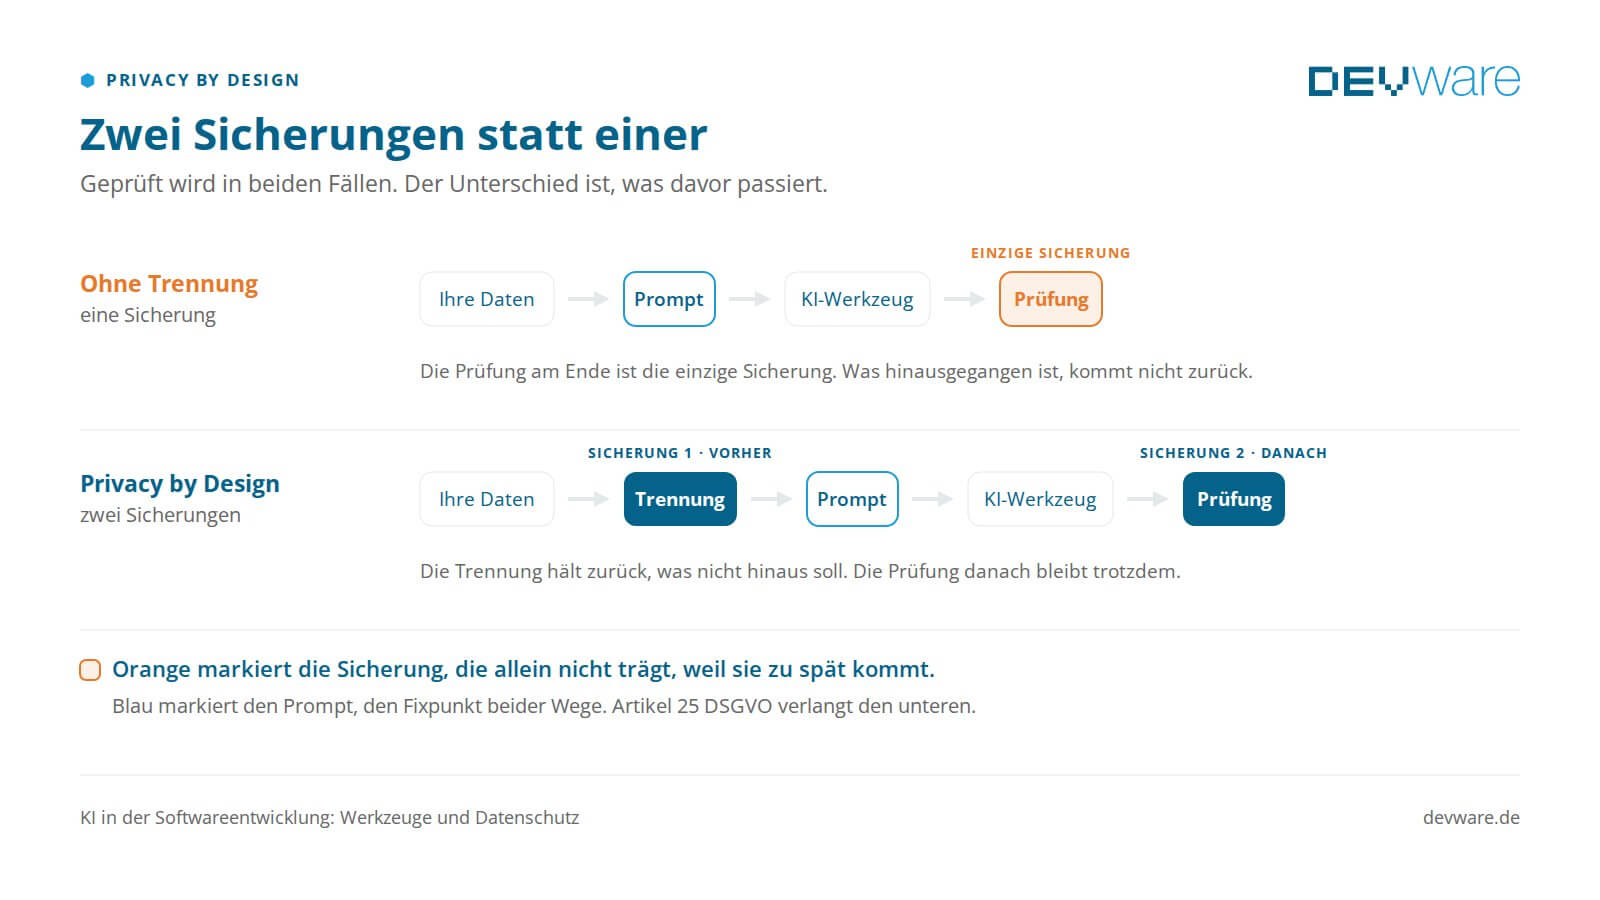
Bestimmte Daten verlassen Ihre Systeme niemals in Richtung KI:
- personenbezogene Daten Ihrer Mitarbeiter oder Kunden
- Produktions- und Echtdaten aus Ihren Systemen
- Passwörter, Zugangsdaten und API-Schlüssel
- sensible Geschäfts- oder Finanzdaten
In die KI fließt ausschließlich das, was für die Entwicklung technisch nötig und datenschutzrechtlich unbedenklich ist:
- abstrakte Code-Logik und Algorithmen
- Quellcode-Fragmente, projektbezogen
- technische Konfigurationsdaten, pseudonymisiert
- Telemetriedaten der Entwicklungsumgebung
Der zweite Punkt der ersten Liste ist der wirksamste. Wer mit anonymisierten oder synthetischen Testdaten entwickelt, hat die Frage an der Wurzel gelöst: In der Entwicklungsumgebung liegen dann keine Echtdaten, die versehentlich als Kontext mitgehen könnten.

Schutzstufen je KI-Werkzeug
Für jedes eingesetzte Werkzeug dokumentieren wir Schutzstufe, Absicherungsmechanismus und Nachweis, sodass alle auf einen Blick vergleichbar sind.
Warum der Auftragsverarbeitungsvertrag Ihren Quellcode nicht abdeckt
Das ist der Punkt, an dem die meisten Lieferantenprüfungen aneinander vorbeireden, und er ist wichtiger als jede Werkzeugliste.
Ein Auftragsverarbeitungsvertrag nach Artikel 28 DSGVO regelt die Verarbeitung personenbezogener Daten. Quellcode ist in aller Regel nicht personenbezogen. Er ist urheberrechtlich geschütztes Werk nach Paragraf 69a Urheberrechtsgesetz und, soweit er nicht öffentlich ist, Geschäftsgeheimnis.
Daraus folgen zwei Dinge, die regelmäßig übersehen werden.
Erstens schützt ein vorliegender Auftragsverarbeitungsvertrag Ihren Quellcode nicht. Er ist trotzdem nötig, sobald in Ihren Systemen personenbezogene Daten liegen, aber für diese Frage ist er der falsche Vertrag. Die richtige Stelle sind die Vertraulichkeitsregelungen im Projektvertrag, und die müssen die Weitergabe an Dritte, also auch an KI-Anbieter, ausdrücklich erfassen.
Zweitens hängt am Geschäftsgeheimnisgesetz eine Bedingung, die wenig bekannt ist: Eine Information ist nur dann rechtlich als Geschäftsgeheimnis geschützt, wenn sie durch angemessene Geheimhaltungsmaßnahmen geschützt wird. Wer nicht regelt, welche Werkzeuge seinen Code sehen dürfen, riskiert im Streitfall nicht nur den Abfluss, sondern auch das Argument, dass es sich mangels Schutzmaßnahmen gar nicht um ein Geschäftsgeheimnis handelte.
Die Regelung ist damit kein Formalismus. Sie ist die Voraussetzung dafür, dass Sie sich später überhaupt auf den Schutz berufen können.
Chancen und Risiken
Transparenz hat für uns hohe Priorität, deshalb benennen wir beides.
Auf der Chancenseite steht ein spürbarer Effizienzgewinn: schnellere Entwicklung und damit ein früherer Liefertermin, konsistenterer Code, weniger Fehler durch KI-gestützte Code-Reviews und eine technische Dokumentation, die parallel mit entsteht. Der Stundensatz steigt dadurch nicht, der Vorteil geht an Sie.
Die Risiken managen wir aktiv:
- Zugriff durch US-Behörden. Über FISA Section 702 und den CLOUD Act theoretisch möglich. Unsere Transfer Impact Assessments kommen zum Ergebnis: Risiko niedrig. Abstrahierte Codefragmente sind kein typisches Ziel.
- Weitergabe der Daten. Vertraglich über den Auftragsverarbeitungsvertrag ausgeschlossen.
- Training auf Ihren Daten. Über die Geschäftskonten deaktiviert und vertraglich ausgeschlossen, nicht nur per Schalter.
- Fehlerhafte Vorschläge. Fängt die manuelle Prüfung durch unsere Entwickler ab. Ein KI-Vorschlag geht nie ungeprüft in Ihr System.
- Datenabfluss durch Unachtsamkeit. Interne Richtlinie und regelmäßige Schulungen.
Was Sie jeden Dienstleister fragen sollten
Drei Fragen, die den Unterschied sichtbar machen. Sie funktionieren bei uns genauso wie bei jedem anderen Anbieter.
1. Welche KI-Werkzeuge sind im Einsatz, mit Anbieter und Sitz?
Nicht "wir arbeiten mit KI", sondern eine Liste. Jedes Werkzeug, jeder Anbieter, jeder Unternehmenssitz. Sitzt der Anbieter außerhalb der EU, und das ist bei den verbreiteten Werkzeugen der Regelfall, gehören Standardvertragsklauseln und ein Transfer Impact Assessment dazu, sobald personenbezogene Daten im Spiel sind.
Wer diese Liste nicht innerhalb eines Tages liefern kann, führt sie nicht.
2. Ist das Training auf Ihren Eingaben vertraglich ausgeschlossen, und wo steht das?
Die teuerste Frage, wenn sie falsch beantwortet wird. In Privat- und Standardtarifen der gängigen Werkzeuge ist die Nutzung von Eingaben zur Modellverbesserung häufig voreingestellt, in Geschäfts- und Unternehmenstarifen vertraglich ausgeschlossen.
Der Unterschied ist ein Vertrag, kein Schalter in den Einstellungen. Einen Schalter kann jeder umlegen, der Zugriff auf das Konto hat, und niemand merkt es. Lassen Sie sich die Vertragsstelle zeigen, nicht den Screenshot einer Einstellungsseite.
3. Was wird eingespeist und was ausdrücklich nicht?
Eine belastbare Antwort ist zweiseitig. Sie benennt, was hineingeht, und sie benennt, was nicht hineingeht. Eine Antwort, die nur die erste Hälfte enthält, ist unvollständig. Eine, die aus "wir achten auf Datenschutz" besteht, ist keine.
Woran Sie eine belastbare Antwort erkennen
Der Unterschied liegt in der Konkretheit, nicht im Tonfall.
Schwach: "Wir setzen KI datenschutzkonform ein." "Unsere Tools sind DSGVO-konform." "Kundendaten werden selbstverständlich nicht verwendet."
Belastbar: eine Tabelle wie die oben, in der je Werkzeug Anbieter, Sitz, Einsatzzweck und der Status von Auftragsverarbeitungsvertrag, Standardvertragsklauseln, Transfer Impact Assessment und Training stehen. Dazu eine Liste dessen, was nicht eingespeist wird, bis hinunter zu Passwörtern und Echtdaten.
Diese Antwort kann nur geben, wer die Frage vorher schon einmal für sich selbst beantwortet hat.

Was rechtlich inzwischen gilt
Drei Punkte, die den heutigen Stand beschreiben.
Die Rollen sind verteilt und nicht verhandelbar. Seit dem 2. August 2026 gilt der Großteil des EU AI Act. Wer ein KI-System entwickelt und unter eigenem Namen bereitstellt, ist Anbieter. Wer es im eigenen Betrieb einsetzt, ist Betreiber. Aus der Rolle folgen die Pflichten. In einer Auftragsentwicklung sind in der Regel Sie der Anbieter, und Ihr Dienstleister erbringt die technische Leistung.
Die Schulungspflicht betrifft auch Sie. Artikel 4 des EU AI Act verlangt seit dem 2. Februar 2025 von Anbietern und Betreibern, für ausreichende KI-Kompetenz ihrer Mitarbeitenden zu sorgen, gemessen an deren Vorkenntnissen und am Einsatzkontext. Wer KI im Unternehmen einsetzt, ist Betreiber. Die Pflicht endet also nicht beim Dienstleister.
Der Datenschutz ist nicht der ganze Schutz. Die DSGVO deckt personenbezogene Daten ab. Ihr Quellcode, Ihre Preiskalkulation und Ihre Prozessbeschreibungen fallen nicht darunter. Dafür brauchen Sie die Vertraulichkeitsregelungen im Vertrag.
Häufige Fragen
Werden meine Daten für KI-Training genutzt?
Nein. Wir nutzen ausschließlich Geschäfts- und Unternehmenskonten. Dort ist das Training auf Nutzerdaten vertraglich ausgeschlossen und im Auftragsverarbeitungsvertrag schriftlich festgehalten.
Sieht ein KI-Werkzeug unseren gesamten Quellcode?
Nicht zwangsläufig, aber mehr als den markierten Abschnitt. Assistenten, die in der Entwicklungsumgebung mitlaufen, übertragen je nach Werkzeug und Einstellung geöffnete und benachbarte Dateien als Kontext. Wie weit dieser Kontext reicht, ist konfigurierbar und gehört in jede ernsthafte Auskunft.
Reicht ein Auftragsverarbeitungsvertrag, um unseren Quellcode zu schützen?
Nein. Er regelt personenbezogene Daten nach Artikel 28 DSGVO. Quellcode ist urheberrechtlich geschütztes Werk und Geschäftsgeheimnis. Der Schutz gehört in die Vertraulichkeitsregelungen des Projektvertrags, und die müssen die Weitergabe an KI-Anbieter ausdrücklich erfassen.
Können US-Behörden auf meine Daten zugreifen?
Theoretisch ja, über FISA Section 702 und den CLOUD Act. Unsere Transfer Impact Assessments kommen zum Ergebnis: Risiko niedrig. Abstrahierte Codefragmente sind kein typisches Ziel behördlicher Zugriffe.
Werden Daten an Suchmaschinen oder Dritte weitergegeben?
Nein. Was in die KI-Werkzeuge eingegeben wird, verbleibt im jeweiligen System. Eine Weitergabe an Suchmaschinen oder andere Dritte ist vertraglich ausgeschlossen.
Warum muss ich einen Auftragsverarbeitungsvertrag unterzeichnen?
Er ist nach Artikel 28 DSGVO vorgeschrieben, sobald ein Dienstleister personenbezogene Daten im Auftrag verarbeiten könnte. Er regelt, welche Daten wir zu welchem Zweck verarbeiten und welche Schutzmaßnahmen gelten, und schützt damit beide Seiten.
Kann ich als Kunde dem KI-Einsatz widersprechen?
Ja. Der Auftragsverarbeitungsvertrag räumt Ihnen ein Widerspruchsrecht mit einer Frist von 14 Tagen ein. Anschließend klären wir gemeinsam, ob das Projekt ohne KI-Werkzeuge realisierbar ist. Ein Verzicht kann sich auf Zeitplan und Kosten auswirken.
Dürfen wir unserem Dienstleister den KI-Einsatz generell verbieten?
Vertraglich ja. Praktisch führt ein pauschales Verbot selten zum Ziel, weil es entweder den Preis hebt oder unbemerkt umgangen wird. Eine benannte Werkzeugliste mit vertraglich ausgeschlossenem Training ist der wirksamere Weg als ein Verbot, dessen Einhaltung niemand prüft.
Wem gehört Code, den eine KI geschrieben hat?
Die Rechte an der Software in Ihrem Projekt regelt Ihr Vertrag mit dem Dienstleister, unabhängig davon, mit welchen Werkzeugen sie entstanden ist. Achten Sie darauf, dass die Rechteübertragung uneingeschränkt formuliert ist und keine Ausnahme für KI-generierte Anteile enthält.
Was ist der Unterschied zwischen einem Privattarif und einem Geschäftstarif?
Er liegt im Vertrag, nicht in der Funktion. Geschäfts- und Unternehmenstarife enthalten in der Regel den Auftragsverarbeitungsvertrag und den vertraglichen Ausschluss der Nutzung von Eingaben zum Training. Privattarife enthalten beides meist nicht, bei identischer Benutzeroberfläche.
Wie verhindern wir, dass Echtdaten in ein KI-Werkzeug geraten?
Über die Testdaten. Wer mit anonymisierten oder synthetischen Testdaten entwickelt, hat die Frage an der Wurzel gelöst. Die Entwicklung mit Originaldaten aus dem Echtbetrieb ist einer der häufigsten stillen Verstöße im Projektalltag.
Müssen wir unsere Mitarbeiter im Umgang mit KI schulen?
Wenn Sie KI im Unternehmen einsetzen, ja. Artikel 4 des EU AI Act verlangt seit dem 2. Februar 2025 von Betreibern, für ausreichende KI-Kompetenz der Personen zu sorgen, die mit den Systemen arbeiten. Ein bestimmtes Niveau wird nicht vorgeschrieben, wohl aber, dass etwas getan wird.
Was passiert mit den Daten nach Projektende?
Alle überlassenen Daten werden zurückgegeben oder auf Wunsch nachweislich gelöscht. Die KI-Anbieter haben in ihren Auftragsverarbeitungsverträgen definierte Löschfristen und Löschprozesse, die wir vertraglich eingefordert haben.
Was verlangen wir bei einem Wechsel des Dienstleisters?
Dieselbe Auskunft rückwirkend: welche Werkzeuge im Projektzeitraum im Einsatz waren und was dazu vertraglich vereinbart war. Dazu die Bestätigung, dass Projektdaten nach Vertragsende gelöscht oder zurückgegeben werden, mit Frist.
Wie weist Devware die Einhaltung intern nach?
Devware ist nach ISO/IEC 27001:2024 und ISO 9001:2015 zertifiziert. Wir führen ein Verzeichnis von Verarbeitungstätigkeiten nach Artikel 30 DSGVO, haben mit der heyData GmbH eine externe Datenschutzbeauftragte bestellt und schulen unsere Entwickler regelmäßig zum datenschutzkonformen Umgang mit KI-Werkzeugen.
Welche Nachweise Sie darüber hinaus von einem Dienstleister verlangen können, steht unter Compliance-Nachweise beim Softwaredienstleister. Wann personenbezogene Daten in ein KI-System dürfen, unter Kundendaten in KI-Systeme geben. Den vollständigen Stand unserer eigenen Werkzeuge und Verträge finden Sie unter KI-Compliance und Datenschutz.
Hinweis: Dieser Artikel ist eine fachliche Einordnung aus der Sicht eines Softwareentwicklers, keine Rechtsberatung.
Zur Entstehung: Unsere Inhalte entstehen mit Unterstützung von KI, aber jeder Text geht durch eine doppelte menschliche Prüfung, bevor er veröffentlicht wird.
Quellen
- Verordnung (EU) 2016/679, Datenschutz-Grundverordnung, insbesondere Artikel 25, 28, 30, 32 und 44 bis 49.
- Verordnung (EU) 2024/1689, Verordnung über Künstliche Intelligenz, insbesondere Artikel 4 zur KI-Kompetenz, anwendbar seit 2. Februar 2025.
- Gesetz zum Schutz von Geschäftsgeheimnissen (GeschGehG), Paragraf 2.
- Urheberrechtsgesetz, Paragraf 69a, Schutz von Computerprogrammen.
- DIN EN ISO/IEC 27001:2024, Informationssicherheitsmanagementsysteme.