Kundendaten in KI-Systeme geben: wann es erlaubt ist und wie Sie es bauen
TL;DR
Personenbezogene Daten dürfen in ein KI-System, wenn vier Dinge stimmen: Rechtsgrundlage nach Artikel 6 DSGVO, ein Zweck, der auch für die KI-Nutzung gilt, ein Anbieter mit Auftragsverarbeitungsvertrag und bei Sitz außerhalb der EU mit Standardvertragsklauseln und Transfer Impact Assessment, und nur so viele Daten, wie die Aufgabe braucht. Die schwierigere Frage ist die bauliche: Daten vor dem Aufruf reduzieren, zur Laufzeit nachschlagen statt trainieren, Berechtigungen prüfen, keine Entscheidung ohne Menschen.
Die kurze Antwort
Ja, unter Bedingungen. Die DSGVO verbietet KI nicht, sie stellt Anforderungen an die Verarbeitung.
Interessant ist eine andere Beobachtung: In den Projekten, die wir sehen, scheitert es fast nie an der Rechtslage. Es scheitert daran, dass niemand im Haus sagen kann, welche Daten im betroffenen System überhaupt personenbezogen sind. Solange diese Frage offen ist, ist jede Diskussion über Rechtsgrundlagen theoretisch.
Der Rest dieses Artikels geht deshalb zwei Wege parallel: die vier rechtlichen Prüfschritte, und die vier Bauweisen, mit denen sich das Risiko technisch senken lässt, bevor es juristisch bewertet werden muss.
Teil 1: die vier Prüfschritte vor dem ersten Prompt
Rechtsgrundlage: Artikel 6 DSGVO
Jede Verarbeitung personenbezogener Daten braucht eine Rechtsgrundlage. Für die meisten Anwendungsfälle im Mittelstand kommen drei in Betracht: die Erfüllung eines Vertrags, eine rechtliche Verpflichtung, oder das berechtigte Interesse. Die Einwilligung ist die unbeliebteste Grundlage, weil sie jederzeit widerrufen werden kann und dann die Verarbeitung endet.
Beim berechtigten Interesse ist eine Abwägung zu dokumentieren: Ihr Interesse gegen die Interessen der betroffenen Personen. Diese Abwägung muss schriftlich vorliegen, bevor das System läuft, nicht danach.
Zweckbindung: gilt Ihr alter Zweck auch für die KI?
Das ist die Stelle, an der die meisten Vorhaben stolpern. Daten wurden für einen bestimmten Zweck erhoben, etwa zur Vertragsabwicklung. Sie jetzt in ein KI-System zu geben, das Muster erkennt oder Vorschläge macht, kann ein anderer Zweck sein. Dann braucht es entweder eine Vereinbarkeitsprüfung nach Artikel 6 Absatz 4 oder eine neue Grundlage.
Praktisch heißt das: Prüfen Sie nicht, ob Sie die Daten haben dürfen. Prüfen Sie, ob Sie sie für diesen neuen Zweck verwenden dürfen.
Datenminimierung: was die Aufgabe wirklich braucht
Ein Sprachmodell, das Supportanfragen kategorisieren soll, braucht den Text der Anfrage. Es braucht nicht den Namen, nicht die Kundennummer, nicht die Rechnungshistorie. Jedes Feld, das Sie weglassen, ist ein Feld, das nicht abfließen kann.
Das ist kein rechtlicher Rat, sondern Konstruktion. Datenminimierung ist die einzige Maßnahme, die auch dann noch wirkt, wenn alles andere versagt.
Transparenz: steht es in Ihrer Datenschutzerklärung?
Betroffene Personen haben ein Recht darauf zu erfahren, wie ihre Daten verarbeitet werden. Wenn ein KI-System dazugekommen ist, gehört das in die Informationen nach Artikel 13 und 14, und die Verarbeitung gehört ins Verzeichnis von Verarbeitungstätigkeiten nach Artikel 30.
Teil 2: der Anbieter
Sobald ein externes Modell im Spiel ist, ist dessen Anbieter Auftragsverarbeiter. Drei Punkte, die geklärt sein müssen, bevor der erste Datensatz das Haus verlässt:
Auftragsverarbeitungsvertrag nach Artikel 28. Ohne ihn ist die Verarbeitung rechtswidrig, und zwar auf Ihrer Seite.
Drittlandtransfer. Sitzt der Anbieter außerhalb der EU, und das ist bei den großen Modellen der Regelfall, braucht es die EU-Standardvertragsklauseln und ein Transfer Impact Assessment, also eine dokumentierte Einschätzung des Schutzniveaus im Zielland. Bei US-Anbietern kommt die Zertifizierung nach dem EU-US Data Privacy Framework hinzu, die öffentlich einsehbar ist.
Training auf Ihren Eingaben. In Privat- und Standardtarifen ist die Nutzung von Eingaben zur Modellverbesserung oft voreingestellt, in Geschäfts- und Unternehmenstarifen vertraglich ausgeschlossen. Der Unterschied ist ein Vertrag, kein Schalter in den Einstellungen, auf den man sich verlassen sollte. Lassen Sie sich die Stelle im Vertrag zeigen.
Teil 3: die vier Bauweisen
Hier liegt der Teil, den die meisten Texte zu diesem Thema auslassen. Die Rechtslage ist für alle gleich. Der Unterschied entsteht in der Architektur.
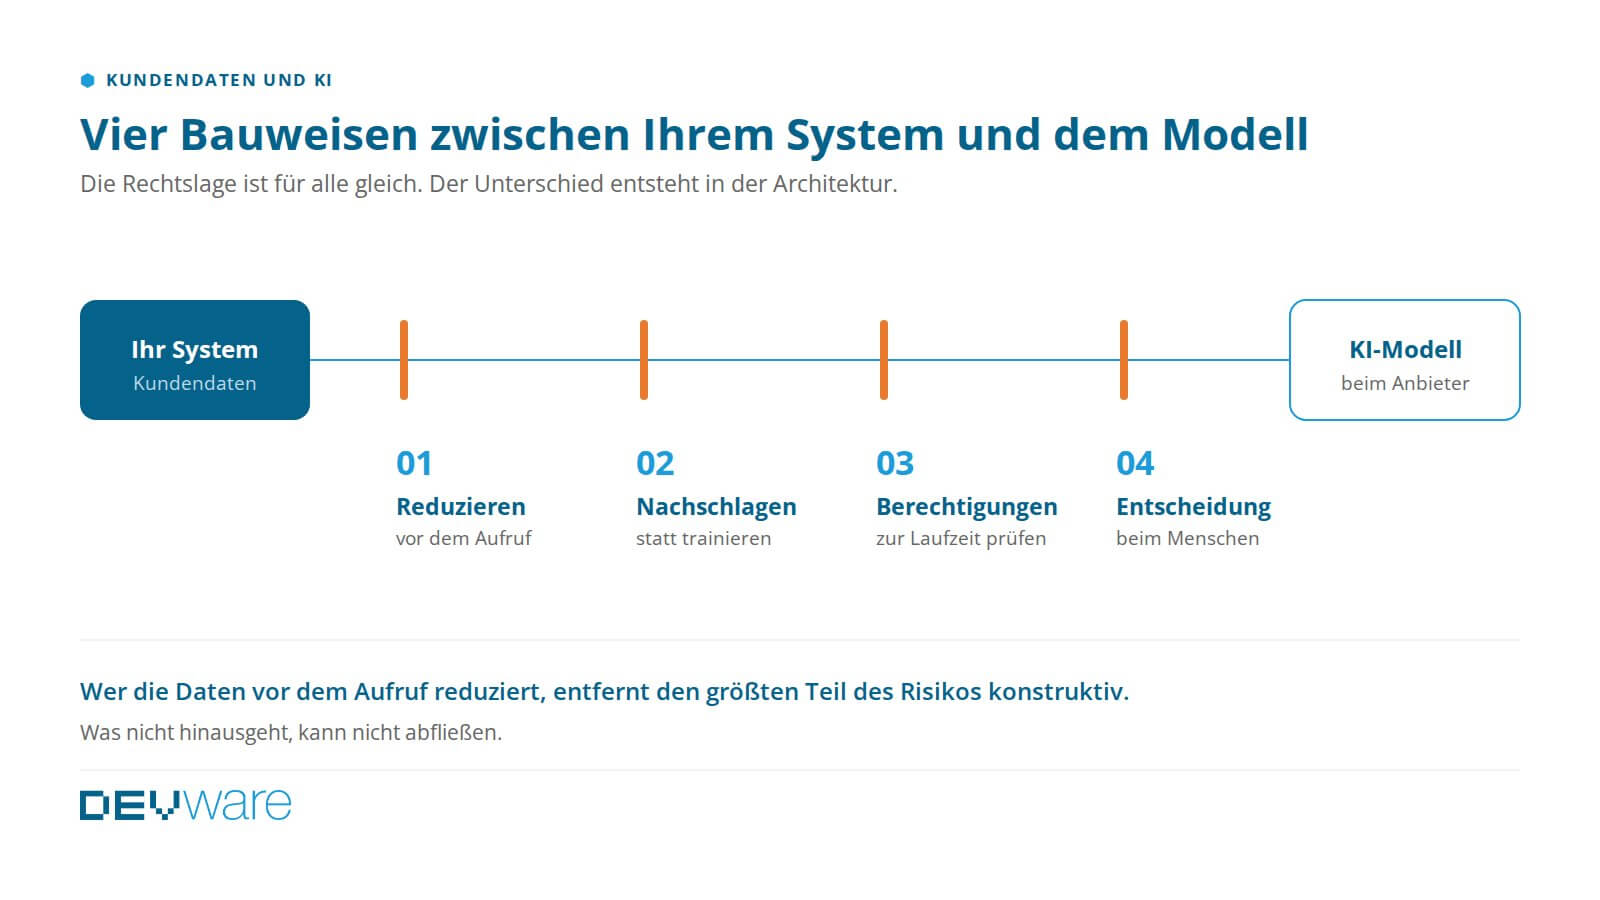
1. Reduzieren vor dem Aufruf
Zwischen Ihrem System und dem Modell sitzt eine Schicht, die Namen, Kundennummern, Adressen, Vertragsnummern und Freitextfelder mit Personenbezug ersetzt, bevor der Aufruf hinausgeht, und die Platzhalter in der Antwort wieder zurücksetzt. Das Modell arbeitet mit "Kunde A", Ihr Anwender sieht den richtigen Namen.
Das ist Aufwand in der Entwicklung und der wirksamste einzelne Hebel, den es gibt. Wichtig: Eine Ersetzung, die sich zurückrechnen lässt, ist Pseudonymisierung, keine Anonymisierung. Pseudonyme Daten bleiben personenbezogen und bleiben unter der DSGVO. Wer das verwechselt, baut auf einer falschen Annahme.
2. Nachschlagen statt trainieren
Ein eigenes Modell auf Ihren Daten zu trainieren, bindet diese Daten dauerhaft in das Modell ein. Sie wieder herauszubekommen, etwa nach einem Löschverlangen, ist technisch kaum möglich.
Die Alternative: Das Modell bleibt unverändert, und die relevanten Inhalte werden zur Laufzeit aus Ihrer Datenbank nachgeschlagen und dem Modell als Kontext mitgegeben. Löschen Sie den Datensatz, ist er beim nächsten Aufruf weg. Das ist der Unterschied zwischen einem Löschkonzept, das funktioniert, und einem, das behauptet wird.
3. Berechtigungen zur Laufzeit prüfen
Ein interner Assistent, der auf Dokumente zugreift, muss dieselben Rechte anwenden wie das Quellsystem. Sonst beantwortet er der Sachbearbeiterin Fragen zu Gehältern, weil die Datei in einem Ordner lag, den niemand geprüft hat.
Das ist kein hypothetisches Problem, sondern der häufigste Fund, wenn ein Assistent auf ein historisch gewachsenes Dateiablagesystem gerichtet wird. Die Rechte müssen bei jedem Aufruf gelten, nicht bei der Einrichtung.
4. Kein Automatismus ohne Menschen
Artikel 22 DSGVO gibt betroffenen Personen das Recht, nicht einer ausschließlich automatisierten Entscheidung unterworfen zu werden, die rechtliche Wirkung entfaltet oder sie erheblich beeinträchtigt. Bonitätsentscheidungen, Bewerbungsvorauswahl, Kündigungen.
Der praktische Ausweg ist selten die Rechtfertigung und meistens die Bauweise: Das System schlägt vor, ein Mensch entscheidet und kann den Vorschlag ändern. Damit ist die Entscheidung nicht ausschließlich automatisiert. Wichtig ist, dass diese Prüfung echt ist. Ein Häkchen, das in 99 Prozent der Fälle durchgewinkt wird, ist keine.
Teil 4: zwei Dinge, die danach kommen
Datenschutz-Folgenabschätzung. Nach Artikel 35 nötig, wenn die Verarbeitung voraussichtlich ein hohes Risiko birgt. Bei neuen Technologien, umfangreicher Verarbeitung besonderer Datenkategorien oder systematischer Bewertung persönlicher Aspekte ist sie der Regelfall, nicht die Ausnahme. Die Aufsichtsbehörden führen Listen mit Verarbeitungen, bei denen sie verpflichtend ist.
EU AI Act. Seit dem 2. August 2026 gilt der Großteil der Verordnung. Sie kommt zur DSGVO hinzu, sie ersetzt nichts. Für die Praxis wichtig ist zuerst die Rollenverteilung: Wer ein KI-System entwickelt und unter eigenem Namen bereitstellt, ist Anbieter. Wer es im eigenen Betrieb einsetzt, ist Betreiber. Aus der Rolle folgen die Pflichten, und die Rolle ist nicht verhandelbar.
Die unbequeme Stelle
Die häufigste Antwort auf diesen Artikel wird sein: "Wir anonymisieren doch."
In den meisten Fällen stimmt das nicht. Namen zu ersetzen, während Geburtsdatum, Postleitzahl und Vertragsbeginn im Datensatz stehen bleiben, ist keine Anonymisierung. Die Kombination weniger Merkmale reicht regelmäßig aus, um eine Person wieder zu bestimmen. Und Freitextfelder, in denen Mitarbeiter über Jahre Notizen hinterlassen haben, enthalten fast immer Personenbezug, den keine Feldliste erfasst.
Anonym ist ein Datensatz erst, wenn die Person mit verhältnismäßigem Aufwand nicht mehr bestimmbar ist. Alles darunter ist Pseudonymisierung, und die bleibt unter der DSGVO. Der Unterschied ist nicht sprachlich, er entscheidet darüber, ob die gesamte Verordnung gilt oder nicht.
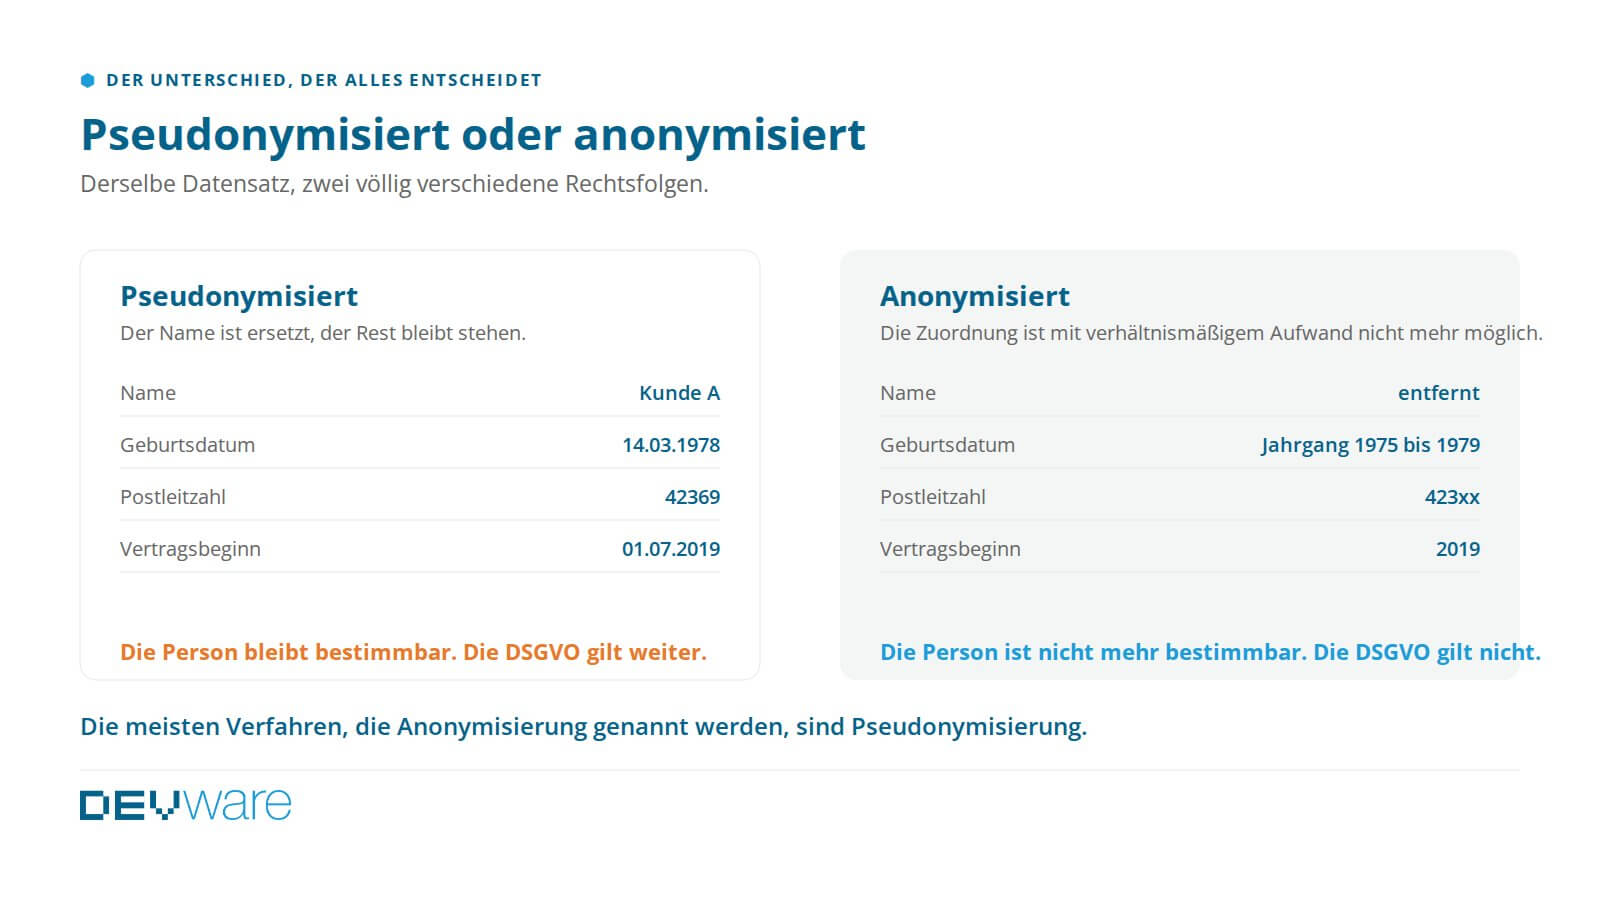
Wer ehrlich pseudonymisiert und das auch so nennt, steht besser da als jemand, der anonymisiert behauptet und im Prüffall das Gegenteil belegt bekommt.
Häufige Fragen
Dürfen wir personenbezogene Daten in ChatGPT eingeben?
Nicht im privaten Tarif. Dort fehlt in der Regel der Auftragsverarbeitungsvertrag, und Eingaben können zur Modellverbesserung genutzt werden. In Geschäfts- und Unternehmenstarifen ist beides geregelt. Entscheidend ist nicht das Werkzeug, sondern der Vertrag dahinter.
Was ist der Unterschied zwischen anonymisiert und pseudonymisiert?
Anonymisiert heißt: Die Person ist mit verhältnismäßigem Aufwand nicht mehr bestimmbar, die DSGVO gilt nicht mehr. Pseudonymisiert heißt: Die Zuordnung ist mit einer zusätzlichen Information wiederherstellbar, die DSGVO gilt weiter. Die meisten Verfahren, die als Anonymisierung bezeichnet werden, sind Pseudonymisierung.
Brauchen wir eine Einwilligung unserer Kunden, um KI einzusetzen?
Nicht zwingend. Eine Einwilligung ist nur eine von mehreren Rechtsgrundlagen und oft die unpraktischste, weil sie widerrufbar ist. Häufig tragen Vertragserfüllung oder berechtigtes Interesse. Die Wahl der Grundlage gehört dokumentiert, bevor das System startet.
Müssen wir eine Datenschutz-Folgenabschätzung machen?
Wenn die Verarbeitung voraussichtlich ein hohes Risiko für die Rechte betroffener Personen birgt, ja. Bei KI-Systemen mit personenbezogenen Daten ist das häufig der Fall. Ihr Datenschutzbeauftragter oder Ihre Aufsichtsbehörde gibt Ihnen die Liste der Verarbeitungen, bei denen sie verpflichtend ist.
Dürfen wir Kundendaten zum Training eines eigenen Modells verwenden?
Rechtlich möglich, praktisch riskant. Trainierte Daten lassen sich aus dem Modell kaum wieder entfernen, ein Löschverlangen läuft damit ins Leere. Nachschlagen zur Laufzeit erreicht in fast allen Fällen dasselbe Ziel und bleibt löschbar.
Wo müssen die Daten liegen?
In der EU ist es am einfachsten. Außerhalb ist es zulässig, wenn Standardvertragsklauseln, Transfer Impact Assessment und gegebenenfalls eine Zertifizierung nach dem Data Privacy Framework vorliegen. "In der Cloud" ist keine Ortsangabe, lassen Sie sich Region und Rechenzentrumsstandort schriftlich geben.
Wer haftet, wenn das KI-System etwas Falsches ausgibt?
Gegenüber betroffenen Personen bleibt der Verantwortliche in der Pflicht, also das Unternehmen, das die Verarbeitung bestimmt. Das ist einer der Gründe für die vierte Bauweise oben: Wo ein Mensch entscheidet, gibt es eine prüfbare Entscheidung.
Was wir dabei übernehmen
Wir bauen die Schicht zwischen Ihrem System und dem Modell: die Reduktion der Daten vor dem Aufruf, das Nachschlagen statt Trainieren, die Rechteprüfung zur Laufzeit und die Protokollierung, mit der sich im Zweifel belegen lässt, was wann an wen ging.
Was wir nicht tun, ist die rechtliche Bewertung Ihres Einzelfalls. Dafür arbeiten wir mit unserer externen Datenschutzbeauftragten zusammen, der heyData GmbH, und für Ihren Fall ist Ihr eigener Datenschutzbeauftragter oder eine Fachanwältin zuständig.
Wie wir selbst mit KI-Werkzeugen umgehen, welche im Einsatz sind und was vertraglich dahintersteht, steht offen auf unserer Seite zu KI-Compliance und Datenschutz.
Warum diese Fragen so früh geklärt sein müssen und woran KI-Projekte sonst scheitern, steht unter Warum KI-Projekte scheitern.
Hinweis: Dieser Artikel ist eine fachliche Einordnung aus der Sicht eines Softwareentwicklers, keine Rechtsberatung.
Zur Entstehung: Unsere Inhalte entstehen mit Unterstützung von KI, aber jeder Text geht durch eine doppelte menschliche Prüfung, bevor er veröffentlicht wird.
Quellen
- Verordnung (EU) 2016/679, Datenschutz-Grundverordnung, insbesondere Artikel 5, 6, 13, 14, 22, 28, 30, 32, 35 und 44 bis 49.
- Verordnung (EU) 2024/1689, Verordnung über Künstliche Intelligenz.
- Erwägungsgrund 26 DSGVO zur Bestimmbarkeit einer Person.
- Listen der Aufsichtsbehörden zu verpflichtenden Datenschutz-Folgenabschätzungen.
- EU-US Data Privacy Framework, öffentliche Teilnehmerliste des US-Handelsministeriums.